AI BOX
边缘 AI 计算终端
Armv9 12 核 CPU 与 45 TOPS NPU,可选配 200 / 400 / 800 TOPS GPU。
百亿参数级大模型与 128 路视频在设备端运行。
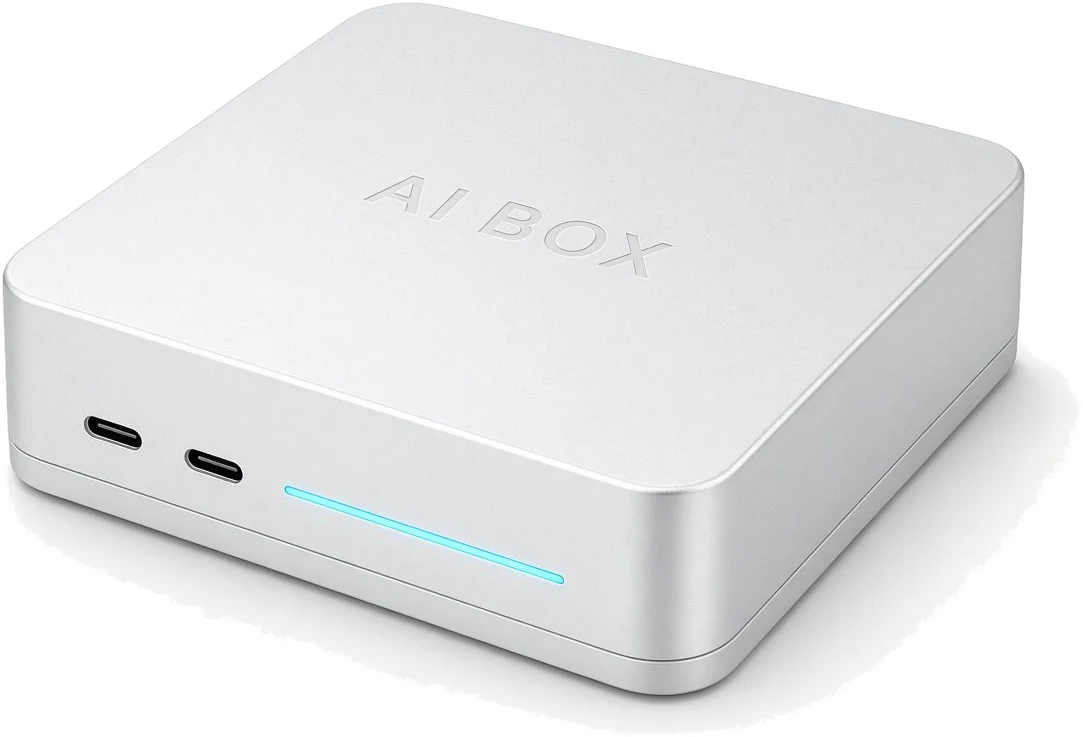
45TOPS
NPU 算力
INT8,全系标配
400TOPS
GPU 算力
INT8,Max 版
64GB
GPU 显存
Max 版
128路
1080p@30fps 解码
另 16 路编码
版本
四个版本
同一机身与主板,CPU、NPU、内存、存储相同,按 GPU 算力与显存区分。标准版不含 GPU。
NPU 45 TOPS(全系) GPU(INT8)
| 标准版 | Pro | Max | Pro Max | |
|---|---|---|---|---|
| 计算单元 | CPU + NPU | CPU + NPU + GPU | CPU + NPU + GPU | CPU + NPU + GPU |
| NPU(INT8) | 45 TOPS | 45 TOPS | 45 TOPS | 45 TOPS |
| GPU(INT8) | — | 200 TOPS | 400 TOPS | 800 TOPS |
| 显存 | — | 32 GB | 64 GB | 128 GB |
| CPU | Armv9 12 核 | Armv9 12 核 | Armv9 12 核 | Armv9 12 核 |
| 内存 | 16 GB LPDDR5x,最大 64 GB | 16 GB LPDDR5x,最大 64 GB | 16 GB LPDDR5x,最大 64 GB | 16 GB LPDDR5x,最大 64 GB |
| 定位 | 对标 NVIDIA Jetson Orin 系列 | 中等规模模型本地推理 | 百亿参数级模型本地推理 | 更大规模模型与多任务并发 |
Max 版参数来自产品规格书 V1.0;功耗、尺寸、本地模型清单为 Max 版数值,其他版本以对应规格书为准。
异构计算
CPU、NPU、GPU 分工
控制与调度在 CPU,常驻视觉与中等规模模型在 NPU,大模型与并行计算在 GPU。三类计算单元在同一台设备内协同,机器人可按“大小脑一体”架构部署。
CPU
Armv9 12 核
A720 × 8 + A520 × 4,整机 > 300 KDMIPS
- 任务调度与业务逻辑
- SLAM、路径规划、运动控制
- ROS 节点与设备驱动
NPU
45 TOPS
INT8,全系标配
- 视觉检测与识别模型
- Qwen3-30B-A3B、Qwen3-VL-30B-A3B
- 低功耗常驻推理
GPU
400 TOPS
INT8,64 GB 显存(Max 版)
- Qwen3.5-122B-A10B 大模型
- CUDA 兼容并行计算
- 雷达信号、像素级图像处理
本地大模型
122B 参数模型
在设备端运行
Max 版 GPU 运行 Qwen3.5-122B-A10B;NPU 同时运行 30B 级 MoE 语言模型与视觉语言模型。模型、数据与推理过程均在本地。
Max 版规格书列出的已适配模型。
视频处理
128 路视频解码
集成视频编解码单元:128 路 1080p@30fps 解码,16 路 1080p@30fps 编码,支持 H.264、H.265、AVS2。解码后的视频流直接送入 NPU / GPU 分析。
16 路编码 128 路解码
软件与应用
软件生态与应用场景
- GPU 生态
- CUDA 兼容,现有 CUDA 应用可迁移
- 深度学习框架
- PyTorch、TensorFlow、ONNX Runtime、TensorRT
- 多媒体框架
- FFmpeg、GStreamer
- 机器人
- 支持 ROS 各版本
- 操作系统
- Debian 12 / Ubuntu 26.04
机器人导航与运动控制
同时运行 SLAM、路径规划、避障算法,与底层运动控制单元协同;CPU 承担控制,NPU / GPU 承担感知与决策模型。
本地大模型推理
边缘 AI 助手、医疗影像、工业质检等场景,在设备端运行 LLM 与 VLM,数据不出现场。
多路视频分析
128 路 1080p 解码,运行目标检测、行为识别、异常检测,减少视频上传带宽。
并行计算
雷达信号并行处理、大规模图像像素级处理、批量数据加密等数据密集型任务。
应用方案
企业 Agent 端云混合
AI BOX 作为企业 Agent 的模型入口。A 类确定性任务由本地程序执行,B 类常规语义任务由本地大模型处理,C 类复杂多步骤任务与 D 类高风险任务经出网策略调用云端模型。
- 统一接入
- OpenAI 兼容 API;云端 API Key 由设备加密保管,不下发给员工和 Agent
- 结果校验
- 本地输出检查格式、字段、取值范围与原文可追溯性;不通过、超时或命中复杂特征时升级上云并记录原因
- 出网策略
- 按数据敏感等级设为禁止出网、脱敏后出网或仅允许指定云厂商
- 审计与预算
- 每次调用记录用户、类别、实际模型、升级原因、Token 与耗时;按用户、部门设置日 / 月预算
硬件
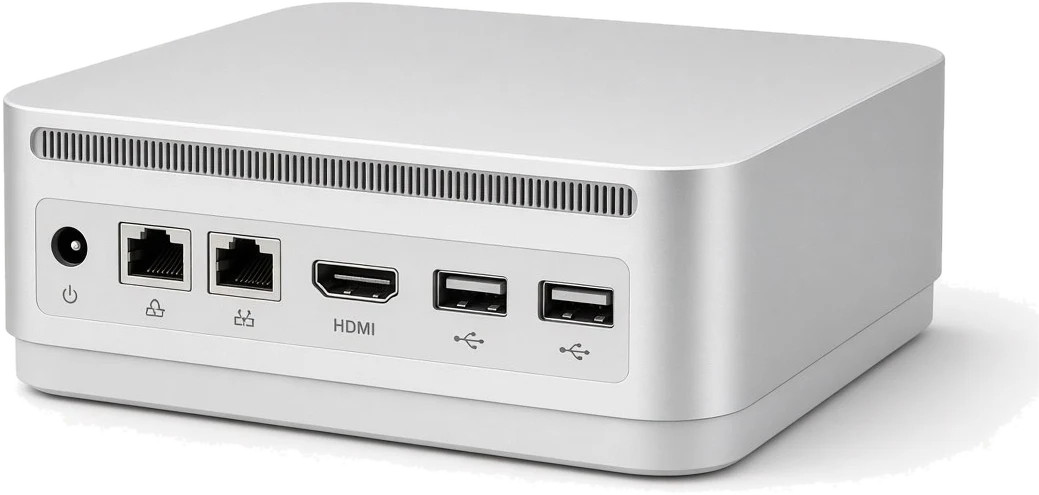
135 × 135 × 63 mm
铝合金机身,典型功耗 < 95 W(Max 版)。前面板 2 × USB 3.2 Type-C 与状态灯;背部 DC 电源、2 × RJ45、HDMI、2 × USB 3.2 Type-A。Wi-Fi 6E、蓝牙与 5G / 4G 可扩展。
技术规格
| 型号 | XSCD_NX_PRO(Max 版) |
|---|---|
| CPU | Arm A720 × 8 + A520 × 4,Armv9 架构,12 核 |
| NPU | 45 TOPS @ INT8 |
| GPU | 400 TOPS @ INT8(Pro Max 版 800 TOPS) |
| 显存 | 64 GB |
| 内存 | 16 GB LPDDR5x,最大 64 GB |
| 存储 | 512 GB NVMe SSD;TF 卡扩展 |
| 网络 | 2 × RJ45;可扩展 Wi-Fi 6E / 蓝牙;可扩展 5G / 4G |
| 显示 | 1 × HDMI 2.0 / 2.1,最高 4K |
| USB | 2 × USB 3.2 Type-C,2 × USB 3.2 Type-A |
| 视频编码 | 16 路 1080p@30fps,H.264 / H.265 / AVS2 |
| 视频解码 | 128 路 1080p@30fps,H.264 / H.265 / AVS2 |
| 本地模型 | NPU:Qwen3-30B-A3B、Qwen3-VL-30B-A3B;GPU:Qwen3.5-122B-A10B;ASR:FireRedASR2-LLM |
| 软件 | Debian 12 / Ubuntu 26.04;CUDA 生态;PyTorch、TensorFlow、ONNX Runtime;FFmpeg、GStreamer;ROS |
| 功耗 | 典型 < 95 W |
| 尺寸 | 135 × 135 × 63 mm |
| 工作温度 | 0~50℃(商业级) |
参数来自 XSCD_NX_PRO 产品规格书 V1.0(2026 年 10 月),为 Max 版配置,以最终量产版本为准。